
• Онлайн: 2

Представьте, что вам нужно передать другу секретное сообщение, но есть только два символа: 0 и 1. Это так называемый бинарный код. Никаких букв, никаких пробелов, никаких знаков препинания. Только бесконечная лента из нулей и единиц. Как быть?
Первое, что приходит в голову — придумать таблицу, где каждой букве соответствует свой набор из нулей и единиц. Например:
| буква | код |
|---|---|
| А | 0 |
| Б | 1 |
Отлично, но букв в алфавите гораздо больше двух. Значит, их коды будут длиннее:
| буква | код |
|---|---|
| А | 00 |
| Б | 01 |
| В | 10 |
| Г | 11 |
Теперь можно закодировать слово «БАГА»: 01 + 00 + 11 + 00 = 01001100. Красиво! Но вот беда: у нас всего четыре буквы, а хочется закодировать весь алфавит. Если использовать стандартные кодовые 8-битные таблицы, то у нас на эти 4 символа потратится уже 32 бита. Есть и 7-битные таблицы кодировки, там будет чуть короче.
А можно ли ещё короче? Попробуем на практике. Возьмём «алфавит» из 32 символов, чтобы влезть в длину кода 5 бит (`2^5=32`). На каждый символ придётся ровно по 5 бит, поэтому разделители не нужны. Длина зашифрованного текста в битах считается очень легко: ДлинаФразы*5.
| буква | код |
|---|---|
| _ | 00000 |
| А | 00001 |
| Б | 00010 |
| В | 00011 |
| Г | 00100 |
| Д | 00101 |
| ЕЁ | 00110 |
| Ж | 00111 |
| З | 01000 |
| И | 01001 |
| Й | 01010 |
| К | 01011 |
| Л | 01100 |
| М | 01101 |
| Н | 01110 |
| О | 01111 |
| П | 10000 |
| Р | 10001 |
| С | 10010 |
| Т | 10011 |
| У | 10100 |
| Ф | 10101 |
| Х | 10110 |
| Ц | 10111 |
| Ч | 11000 |
| Ш | 11001 |
| Щ | 11010 |
| ЪЬ | 11011 |
| Ы | 11100 |
| Э | 11101 |
| Ю | 11110 |
| Я | 11111 |
Если нам надо зашифровать «У ЛУКОМОРЬЯ ДУБ ЗЕЛЁНЫЙ ЗЛАТАЯ ЦЕПЬ НА ДУБЕ ТОМ», то у нас должно получиться кодированное сообщение в 47*5=235 бит. Это намного круче, чем обычное кодирование 8-битными кодами, где получилось бы 47*8=376 бит. Но можно ли ещё укоротить результат без потери информации?
Можно. Что, если сделать коды разной длины? Частым буквам — короткие, редким — длинные. Тогда сообщение станет короче. Но тут же возникает новая проблема, и она гораздо интереснее.
Попробуем такой код:
| Буква | Код |
|---|---|
| А | 0 |
| Б | 1 |
| В | 00 |
| Г | 01 |
Вроде бы красивая и лаконичная кодовая таблица. А теперь попробуем расшифровать вот это: 0011. Что это? «ААББ»? Или «АГБ»? Или «ВББ»? Непонятно. Глядя на строку 0011, невозможно понять, где кончается одна буква и начинается другая.
Проблема вот в чём: код буквы А(0) является началом кода букв В(00) и Г(01). Когда мы читаем сообщение, мы не знаем, остановиться на 0 или читать ещё один символ. Такие коды — плохие. Они не позволяют однозначно расшифровать сообщение, придётся перебирать все возможные варианты, а это может быть очень долго и всё равно непонятно, что выбрать, если закодирован не читаемый текст, а просто некая последовательность символов.
Какой из этого следует вывод? Нужно придумать и сделать такую кодовую таблицу, чтобы в ней ни один код не являлся началом другого кода. И такие коды были, конечно же, придуманы. Из назвали «префиксными».
«Префикс» — это часть слова с его начала. Например, у слова «ПРИВЕТ» префиксы — «П», «ПР», «ПРИ», «ПРИВ», «ПРИВЕ», «ПРИВЕТ», у слова «МИР» префиксы — «М», «МИ» и «МИР».
Наверное, понятнее было бы, если бы такие коды называли наоборот «непрефиксными», но уж как назвали – так назвали. В нашем плохом примере код буквы А был префиксом кода букв В и Г. Именно поэтому мы не смогли декодировать простейшее сообщение из 4 бит. Если запретить такие ситуации, проблема исчезнет.
Главное свойство префиксного кода — однозначная декодируемость без разделителей. Если вы читаете поток битов, закодированный префиксным кодом, вы всегда можете однозначно разбить его на кодовые слова, двигаясь слева направо: как только накопленные биты совпали с каким-то кодовым словом — значит вы нашли очередное слово и можно начинать следующее. Никакой неоднозначности не возникает.
Самый простой префиксный код выглядит так:
| Буква | Код |
|---|---|
| А | 0 |
| Б | 10 |
| В | 110 |
| Г | 1110 |
| Д | 11110 |
| Е | 111110 |
| Ё | 1111110 |
| Ж | 11111110 |
| З | 111111110 |
Здесь ни один код не является началом другого. Проверим: 0 не начало 10, 10 не начало 110, 110 не начало 1110 и т.д. Всё честно. Как это читать? Очень просто. Читаем слева направо и накапливаем символы. Как только накопленное совпало с каким-то кодом из таблицы — мы раскодировали очередную букву, можем продолжать считывать биты до тех пор, пока не «накопим» на очередную букву.
Возьмём 1101001110 и расшифруем:
Получилось: ВБАГ. Всё однозначно, никаких пробелов не нужно. Почему этот код работает? Потому что нолик в конце играет роль точки. Перебираем коды, пока нам встречаются единички, а как только встретили нолик – «стоп, буква закончилась». Очень красивый и простой код, действительно напоминающий лестницу с кучей ступенек.
Минус «лестницы» в том, что длина каждого следующего кода символа увеличивается на 1 бит. Чем дальше буква в алфавите, тем больше единичек перед ноликом. Для последней буквы длина кода будет больше 30 бит и в целом длина зашифрованной фразы получится катастрофически длинной настолько, что с лёгкостью проиграет обычным кодам с «фиксированной» длиной кода. Хотя для короткого словаря выигрыш безусловно будет.
Код Элиаса – это ещё один красивый код — он умеет сам подсказывать, как себя читать:
| Число | Код |
|---|---|
| 1 | 1 |
| 2 | 010 |
| 3 | 011 |
| 4 | 00100 |
| 5 | 00101 |
| 6 | 00110 |
| 7 | 00111 |
| 8 | 0001000 |
Здесь работает такой принцип: сначала идут нули — это подсказка. Надо посчитать сколько вначале идёт нулей до момента, пока встретится первая единичка. Затем увеличить их количество на 1 — и тогда узнаем, сколько двоичных символов нужно считать далее.
Например, такой код: 001010001000. Считаем нули в начале: два нуля. Значит, после них нужно прочитать 2+1=3 следующих за ними бита: 101. А 101 в двоичной системе — это 5. Считаем далее: три нуля в начале, плюс один — четыре бита: 1000. Это 8 в двоичной системе. Значит 001010001000 – это 58.
Код Элиаса хорош тем, что он очень логичен. Им удобно кодировать числа — а значит, и буквы, если заранее договориться, что каждой букве соответствует своё число. Он не самый короткий, но зато понятный.
Когда-то в разделе про моноалфавитные шифры замены я уже упоминал про частотный анализ. Разные буквы используются в текстах с разной частотой – какие-то чаще, какие-то реже. На основании этого можно расшифровывать простые шифры замены, как это делали герои романов Артура Конан Дойла и Эдгара По. Ниже приведена относительная частота встречаемых в тексте букв русского языка, рассчитанная на базе НКРЯ.
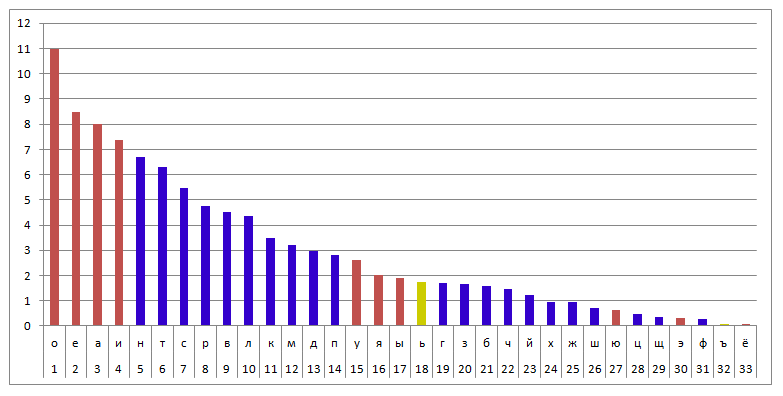
Если самым часто используемым буквам давать короткие коды, а самым редким – длинные, то на этом можно существенно сэкономить. В начале 1950-хх гг аспирант Дэвид Хаффман из Массачусетского технологического института при написании курсовой работы придумал интересный алгоритм, который до сих пор активно применяется в современных цифровых технологиях и базируется как раз на частотности символов. Этот алгоритм так назвали в его честь – алгоритм Хаффмана.
Идея алгоритма состоит в следующем: зная вероятности появления символов в сообщении, можно описать процедуру построения кодов переменной длины, состоящих из целого количества битов. Символам с большей вероятностью ставятся в соответствие более короткие коды. Классический алгоритм Хаффмана на входе получает таблицу частотностей символов в сообщении. Далее на основании этой таблицы строится дерево кодирования Хаффмана (Н-дерево).
Попробуем построить одно из таких деревьев. За основу возьмём таблицу частот НКРЯ:

Для кодирования текстов надо помимо букв использовать хотя бы какой-то разделитель для слов, иначе текст будет совсем нечитаемым. Поэтому добавим к этому алфавиту пробел между словами (обозначим его «_»), получится 34 символа. Для «красоты» ужмём алфавит до 32 символов, «склеив» пару редких букв с похожими по написанию, а именно Ь с Ъ, и Е с Ё. Это не сильно скажется на читаемости восстановленного текста, но зато позволит сэкономить на длине кода. Также сделаем частоты целыми числами, домножив на 100 и округлив. Пробелу дадим самую высокую вероятность, потому что он фактически встречается в каждом слове (в его конце).
Замечу, что вообще-то я категорически против того, что многие вместо Ё используют Е. Это же разные буквы! Почему бы тогда не пойти дальше и не использовать Ь вместо Ъ, И вместо Й, Ш вместо Щ? Или, скажем, Х вместо Ж. В общем, какая-то странная Ё-дискриминация. Ну да ладно, сейчас не об этом.
Итак, у нас получилась вот такая 32-символьная таблица:

Преобразуем её в вертикальный массив данных и сделаем программку, которая будет строить нам дерево.
Если фразу «У ЛУКОМОРЬЯ ДУБ ЗЕЛЕНЫЙ ЗЛАТАЯ ЦЕПЬ НА ДУБЕ ТОМ» кодировать в лоб – по одному байту (8 бит) на символ, то для нашей строки получим 47 байт или 376 бит. А кодом Хаффмана мы её сжали до 221 бита или 28 байт, более чем в полтора раза. Выигрыш получился за счёт того, что частые символы кодируются количеством бит меньшим, чем 8, и к тому же код префиксный, то есть не нужны специальные разделители.
Хочу отметить, что код Хаффмана с длиной закодированного сообщения в 221 бит выигрывает не только у 7- и 8-битных кодовых таблиц, но даже у «идеальной» 5-битной кодовой таблицы, описанной в самом начале, потому что там битовая строка получалась длиной `47*5=235` бит и это казалось круто.
Может показаться, что это просто игра ума. Но префиксные коды — не игрушка, а рабочий инструмент, на котором держится вся современная цифровая жизнь.
Идея везде одна: дать частым символам короткие коды, а редким — длинные. Тогда сообщение в среднем становится короче. А чтобы его можно было прочитать без пробелов, коды делают префиксными.
Есть ещё один занимательный префиксный код – код Фибоначчи. Он построен на одном интересном факте: любое число можно единственным способом собрать из непоследовательных чисел Фибоначчи.
На самом деле префиксных кодов бесконечно много. Может быть, не бесконечно, но много. Для одного и того же алфавита и одного и того же набора вероятностей символов можно построить разные префиксные коды с разной средней длиной кодового слова. Можно это вообще сделать «вручную». Нарисовать дерево: корень, от него две ветки — 0 и 1. На каждой ветке снова развилка 0-1. И так далее. Буквы надо «сажать» только на самые концы веток — никогда в середину. И тогда «путь» до каждой буквы и получится префиксным кодом.

Так как буквы можно сажать «по-разному», на разные листья этого дерева, то этих кодов реально может быть очень-очень много. А раз их много, то конечно же, сразу встаёт задача выбрать из них самые хорошие  Существует целое семейство так называемых оптимальных префиксных кодов — тех, которые минимизируют среднюю длину сообщения при заданных вероятностях (весах) символов. И даже для одного и того же набора весов таких оптимальных кодов тоже может быть несколько. К примеру, некоторые веса могут быть одинаковыми. Или можно вместо «0-слева 1-справа» делать в узлах наоборот «0-справа 1-слева», главное чтобы на каждой развилке одно плечо было 0, а второе 1, а какое из них какое – не важно.
В общем, это уже становится сложным для понимания, главное, что стоит запомнить:
А самое интересное — то, что за внешней простотой этих нулей и единиц прячется целая математика: теория информации, теория вероятностей, теория графов. И если вам захочется заглянуть глубже в дебри кодирования, то вы сможете там обнаружить ещё больше интересного и удивительного.